Built to fail : retour sur KubeCon 2026
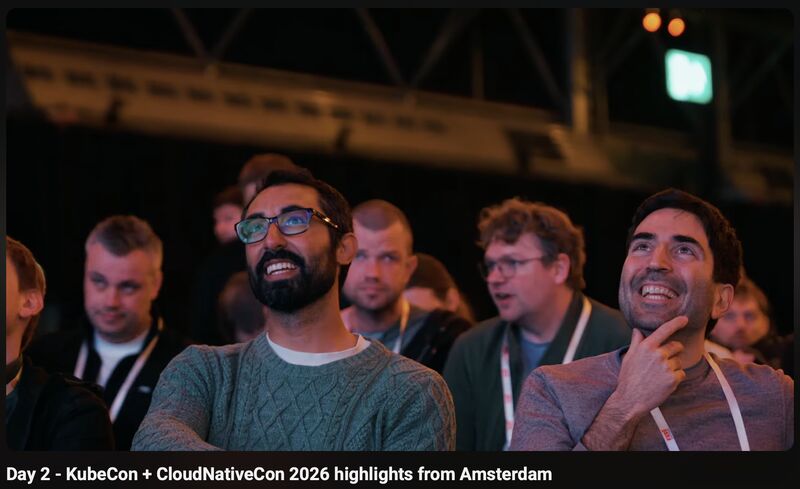
La semaine dernière, nous étions avec une partie de l'équipe au RAI pour KubeCon + CloudNativeCon 2026. Treize mille ingénieurs venus du monde entier, une hypothèse partagée : un logiciel qui compte vraiment pour les clients est un logiciel qui part du principe que quelque chose, quelque part, finira par casser.
Chez DCSolutions, nous appelons cela 'built to fail'. Cela sonne comme une contradiction, alors précisons d'abord ce que cela signifie et ce que cela ne signifie pas.
Le principe de départ
Le logiciel traditionnel est construit sur l'hypothèse que tout continue de fonctionner. La base de données est disponible. Le serveur tourne. Le réseau est en ligne. Quand quelque chose finit malgré tout par mal tourner (et cela arrive toujours, un jour ou l'autre), le problème prend de l'ampleur. Une panne au milieu d'un processus de sinistre. Un portail lent un mardi chargé. Une soumission perdue parce qu'un composant se bloque.
Built to fail renverse cette hypothèse. La plateforme part du principe que quelque chose cassera quelque part, et est conçue pour cela. Plusieurs copies de chaque composant. Redémarrage automatique en cas de défaillance. Une répartition des tâches qui s'adapte quand un nœud disparaît. Le système continue de tourner pendant que certaines de ses parties ne le font pas.
La technologie qui rend cela possible est Kubernetes, et le vaste écosystème cloud native qui l'entoure. C'est de cela que parlait KubeCon.
Trois observations depuis le RAI
Le cloud native n'est plus une niche. Banques, télécoms, administrations, grands distributeurs y font tous tourner des workloads critiques. Ce qui était expérimental il y a dix ans est désormais la manière dont on construit du logiciel sérieux. Nous ne sommes pas les seuls.
L'écosystème est mature. L'outillage autour du monitoring, de la sécurité, du déploiement et de la gestion des données est en place. Pour un fournisseur de plateforme, cela signifie moins de développement maison et davantage de combinaison de composants validés par des milliers d'ingénieurs dans le monde. Ce n'est pas seulement plus efficace, c'est aussi plus sûr.
La conformité a reçu beaucoup d'attention. Les exigences de gouvernance auxquelles les assureurs sont confrontés (DORA, NIS2, AI Act (règlement européen sur l'IA)) étaient très présentes à KubeCon. Les outils natifs d'audit logging, de gestion des secrets et de résidence des données dont vous avez besoin pour ces réglementations font partie de la stack sur laquelle nous construisons. Ce n'est pas un hasard.
(Note au passage : trois collègues apparaissent dans l'aftermovie officiel du jour 2, vers 0:43. Nous en sommes un peu fiers.)
Ce que cela signifie pour les assureurs dommages
Une plateforme de sinistres n'a pas le droit d'être hors service. Pas à moitié. Pas 'un instant'. Une personne qui tente de soumettre des informations un samedi soir après une collision s'attend à ce que cela fonctionne. Un gestionnaire qui récupère ses dossiers le lundi matin s'attend à ce qu'ils soient là. Un partenaire de la chaîne qui doit valider un document attend une réponse en quelques secondes.
Trois propriétés concrètes de notre architecture y répondent.
Une fiabilité indestructible.
Si un composant tombe, un autre reprend immédiatement le même travail. L'utilisateur final ne remarque rien. Pas de longue procédure, pas d'intervention manuelle, pas de tickets de support pour tout relancer.
Une scalabilité qui respire.
Un dimanche calme ou un pic provoqué par un front de tempête avec des centaines de déclarations simultanées : la plateforme s'adapte automatiquement à la charge. Pas de planification de capacité manuelle. Pas de problèmes de performance au mauvais moment.
Une continuité garantie.
Rétablissement automatisé, sauvegardes automatiques, un monitoring qui signale les anomalies avant qu'un utilisateur n'en souffre. Cela fait partie de la conception de base, pas d'un module que l'on coche séparément.
Pas un projet de migration, une couche par-dessus
Ce que nous ne faisons pas : contraindre un assureur à une longue et coûteuse migration hors de ses systèmes existants. Ce genre de trajectoire se termine rarement bien, et n'est dans la plupart des cas pas nécessaire non plus.
Ce que nous faisons : poser une couche intelligente sur l'infrastructure existante, qui relie la chaîne et structure les données. Côté Axon, Axon reste en place. Côté gestionnaire de sinistres, le système en place reste en place. Entre les deux tourne la plateforme de sinistres composable qui assure la communication, orchestre les workflows et enregistre les données pour l'analyse ultérieure et le contrôle de conformité.
Cette plateforme tourne sur l'architecture que KubeCon a de nouveau confirmée la semaine dernière comme le standard. Une plateforme qui fonctionne, tout simplement. Toujours. Parce qu'elle est construite pour encaisser chaque coup.
Les assureurs qui veulent en savoir plus peuvent planifier un entretien via le bouton ci-dessous. Un intake, une démonstration technique. Ensuite, vous savez exactement comment cela fonctionne, et ce que cela signifie pour votre chaîne.